
Угадываем число
Ваш друг загадал число от 1 до 100. Вы хотите как можно быстрее угадать это число, задавая вопросы вида: “Твое число не меньше X?”
Лучшая стратегия: каждым вопросом отсекать половину чисел, которые потенциально могут быть ответом.
Пример:
- Твое число не меньше 50? Вне зависимости от ответа, мы откинем половину чисел: у нас останутся только 1...50 или 51...100. Пусть друг ответил нет - тогда нас интересуют 51...100
- Твое число не меньше 75? Мы снова разделили числа на две равных группы: 51...75 и 76...100 - в любом случае после этого шага останется 25 кандидатов.
- Твое число не меньше 62? В этот раз было 25 кандидатов, поровну поделить нельзя. Поэтому мы делим “почти поровну”: с одной стороны 12 чисел, с другой - 13. То есть в худшем случае у нас останется 13 кандидатов.
Дальше подробно расписывать не будем - процесс повторяется. Каждый ход делим имеющийся диапазон пополам (или “почти пополам”), вопросом отсекаем одну из этих половин. В худшем случае мы при разных размерах половинок попадаем в большую из них, то есть
100 → 50 → 25 → 13 → 7 → 4 → 2 → 1 За 7 вопросов у нас точно останется единственное подходящее число, которое и будет являться ответом.
А что, если наш друг жульничает?
Теперь представим, что друг может подстраиваться под ваши вопросы и менять выбранное число в процессе, но только так, чтобы это не противоречило тем ответам, которые он давал раньше. Как это повлияет на наше решение? Оказывается, ничего не изменится! Все, чем может мешать друг - всегда выбирать тот оттвет, который отсечет меньше чисел. Но поскольку мы всегда делим (почти) пополам, это ни на что не влияет.
Асимптотика
Рассмотрим в общем виде: изначально дано не 100, а N чисел. Мы уменьшаем количество вдвое, пока не получим 1: $N \rightarrow \dfrac{N}{2} \rightarrow \dfrac{N}{4} \rightarrow ... \rightarrow \dfrac{N}{2^K} = 1$ То есть нам понадобится K вопросов, где K такое, что N ≤ 2K.
Логарифм
Логарифм N по основанию 2 (или двоичный логарифм) - это степень, в которую нужно возвести 2, чтобы получить N. Формально log2N = K ⇔ 2K = N. Вместо 2 можно подставить любое другое положительное число и найти логарифм по этому основанию
Таким образом, мы совершим O(logN) действий.
Почему мы не пишем основание логарифма в асимптотике?
Дело в том, что существует формула $log_ab = \dfrac{log_cb}{log_ca}$, т.е. логарифм по любому основанию можно выразить через логарифм по любому другому основанию, домножив на константу $\dfrac{1}{log_ca}$. А константы в асимптотике не учитываются, поэтому основания и не указываются. Однако в большинстве задач по олимпиадной информатики используется двоичный логарифм.
Как быстро растет логарифм?
Короткий ответ: очень медленно. Значения, которые полезно запомнить: - log2105 ≈ 17 - log2106 ≈ 20 - log2(int) ≤ 32 - логарифм любого числа, влезающего в int, не более 32 - log2(longlong) ≤ 64 - аналогично, 64 для long long
Поиск в массиве
Пусть дан отсортированный массив a, в котором мы хотим найти первое вхождение числа X, а если такого нет, первое число, большее него.
Рассмотрим какое-нибудь a[i]. Возможно три случая: 1. a[i] < X. Все числа левее не больше a[i], то есть тоже меньше X, а значит, среди них искать не имеет смысла, можно смело выкинуть их из рассмотрения (вместе с самимa[i]). 2. a[i] > X. Аналогично, все числа правее не меньше a[i], то есть тоже больше X - больше их не рассматриваем. При этом само a[i] может потенциально быть ответом, его не выкидываем. 3. a[i] = X. Числа справа нас больше не интересуют, т.к. даже если среди них есть равные X, мы ищем именно его первое вхождение.
Можно совместить пункты 2-3 и сказать более формально: 1. 1. a[i] < X. “Забываем” все элементы массива с индексами [0; i). 2. 1. a[i] ≥ X. “Забываем” все элементы массива с индексами [i; N).
Таким образом, мы поддерживаем интервал элементов массива, на котором может находиться ответ. Сравнив значение элемента с X, мы можем уменьшить этот интервал. Очень похоже на то, что мы делали раньше! Давайте теперь выбирать не любой элемент, а середину интервала - получится бинпоиск, как в предыдущей задаче.
Реализация
int left = -1, right = n;
while (left + 1 < right) {
    int mid = (left + right) / 2;
    if (a[mid] < X) {
        left = mid;
    } else {
        right = mid;
    }
}
Почему такие странные стартовые значения left и right? По сути в задаче мы ищем границу между числами < X и ≥ X. Для этого мы “зажимаем” ее между left и right - в конце алгоритма они будут стоять по разные стороны от нее, граница строго между ними. При этом в ходе алгоритма поддерживается инвариант: left всегда слева от границы, right соответственно справа. Если мы поставим на старте left = 0, это правило может сломаться, если a[0] окажется больше X. Поэтому мы ставим left = −1, неявно доопределяя a[−1] = −inf Аналогично для right.
В конце выполнения right будет индексом первого элемента a[right] ≥ X или же N, если все числа в массиве меньше X.
lower_bound и upper_bound
Мы только что рассмотрели алгоритм lower_bound - поиск нижней границы. Есть аналогичный ему алгорим upper_bound, который находит первое a[right] > X (обратите внимание, неравенство строгое!). Реализация выглядит так и отличается всего одним символом:
# upper_bound
int left = -1, right = n;
while (left + 1 < right) {
    int mid = (left + right) / 2;
    if (a[mid] <= X) {
        left = mid;
    } else {
        right = mid;
    }
}
Картинка, иллюстрирующая, что находят алгоритмы lower_bound и upper_bound: 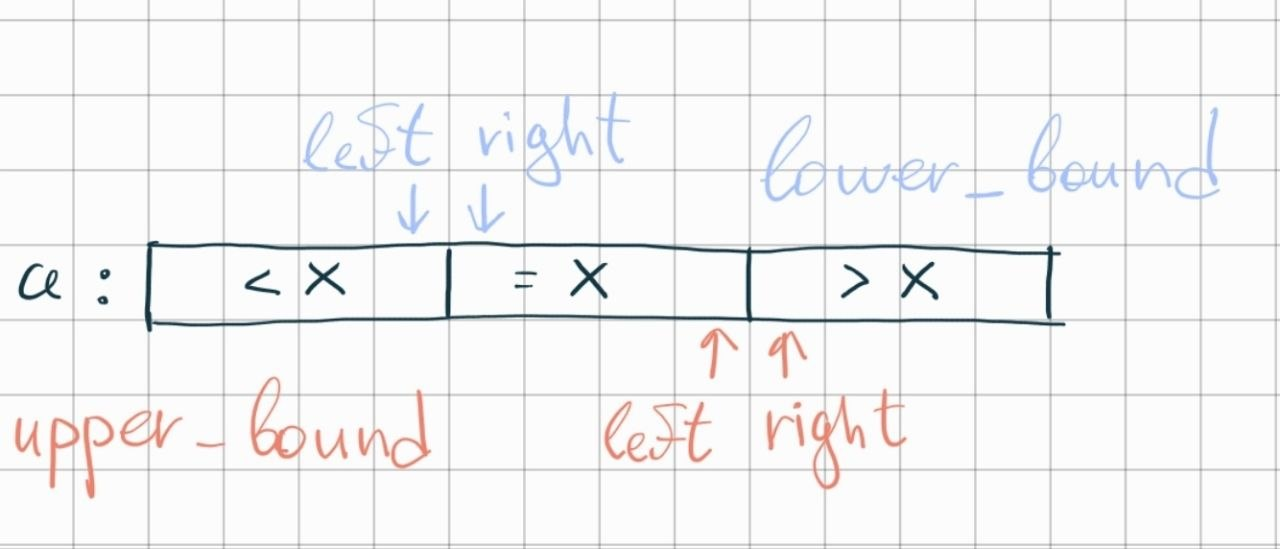
Бинпоиск по функции
Массив из предыдущей задачи можно заменить на возрастающую функцию, и алгоритм не изменится. Пусть f(x) = x3 + 5x2 + 10x + 67. Мы хотим найти такое x, при котором f(x) = K.
Напишем обычный бинпоиск, заменив обращение к массиву на вызов функции и изменив границы
int left = 0, right = 1e9;
while (left + 1 < right) {
    int mid = (left + right) / 2;
    if (f(x) < K) {
        left = mid;
    } else {
        right = mid;
    }
}left и right будут соответственно двумя приближенными решениями на целочисленных x, одно меньше, другое - больше или равно K. Для большинства олимпиадных задач этого достаточно, но иногда мы хотим найти более точный ответ.
Одно из решений: продолжать приближать left и right, пока они почти не сойдутся - расстояние между ними не достигнет какого-нибудь очень маленького значения. Добиться полного равенства мы не можем, так как делить отрезок нецелой блины пополам можно бесконечно долго.
double left = 0, right = 1e9;
double eps = 1e-6;
while (left + eps < right) {
    double mid = (left + right) / 2;
    if (f(x) < K) {
        left = mid;
    } else {
        right = mid;
    }
}
Однако у такого решения могут возникать проблемы с точностью из-за округления double. Часто в задачах ограничение не на абсолютную погрешность (наш eps), а на относительную (отклонение не более чем на r% от верного ответа). Поэтому существует второе решение: ограничим не расстояние между left и right, а количество итераций. Грубо можно считать, что с каждой итерацией точность увеличивается вдвое, так что небольшой константы порядка 100 итераций должно хватить:
double left = 0, right = 1e9;
for (int i = 0; i < 100; ++i) {
    double mid = (left + right) / 2;
    if (f(x) < K) {
        left = mid;
    } else {
        right = mid;
    }
}
Бинпоиск по ответу
Рассмотрим на примере задачи: Даны два принтера. Требуется напечатать документ состоящий из N страниц. Принтеры работают с неодинаковой скоростью. Один печатает страницу за X секунд, а другой за Y. Какое минимальное время они могут затратить на печать всего документа?
Как решать эту задачу напрямую не очень понятно. Зато можно легко проверить, является ли наш ответ корректным, то есть можно ли за K секунд напечатать нужное количество копий. Давайте сделаем бинпоиск, где left - недостаточное время, а right - за которое можно напечатать хотя бы N копий.
int left = 0, right = N * X;
while (left + 1 < right) {
    int mid = (left + right) / 2;
    if (mid / X + mid / Y < N) {
        left = mid;
    } else {
        right = mid;
    }
}
Такую же идею можно применить ко многим другим задачам. Главный критерий чтобы определить задачу на бинпоиск по ответу - до определенного значения ответ не подходит, а затем - подходит, т.е. есть граница между неверными и верными ответами. По сути, это бинпоиск по функции “достаточно ли это число большое, чтобы быть ответом”. В нашем случае это функция f(k) = bool(k/X + k/Y ≥ N).